版本
- MySQL 8.0.14
准备
在 MySQL 8.0.14 版本 InnoDB 引擎发布了一个新的特性 Parallel read of index (并行索引读取),主要用于并行的读取索引数据,目前仅仅支持 SELECT COUNT() 和 CHECK TABLE 操作,InnoDB 后续对于其他操作还会有更多的优化支持。通过这个并行索引读取框架,InnoDB 可以支持同步、异步的并发读取索引数据,异步的读取索引数据可以用来实现逻辑预读操作。在此之前的预读逻辑,InnoDB 只有线性预读和随机预读这两种物理预读处理方法,而对于 B+ tree 这种树形结构显然逻辑预读才更合适。
并行索引读取
参数
- innodb_parallel_read_threads:当前并行读取的 worker 线程数量。
innodb_parallel_read_threads 是 session 级别的变量,假如需要打开并行扫描框架即:
set local innodb_parallel_read_threads=4;

select count(*) from sbtest.table;
设计思想
Parallel read of index 主要利用当前的多核硬件优势,针对当前可以并行读取的逻辑例如 SELECT COUNT() 或者 CHECK TABLE,其主要逻辑是收集数据叶子节点的 Page Number,使用多个 worker 并行读取数据 Page,利用不同的回调函数来处理获取后的 rows。目前 SELET COUNT() 和 CHECK TABLE 都是同步读取,但 InnoDB 依然提供了接口处理对应的异步读取,后续会针对需要异步读取的场景提供更多的优化路径。
实现
row_scan_index_for_mysql()
row_scan_index_for_mysql() 作为 SELECT COUNT() 和 CHECK TABLE 的入口函数:
 /* 扫描索引数据 */
 ----------------------------
| row_scan_index_for_mysql() |
 ----------------------------
  |
  |
  |         /* SELECT COUNT() */
  |    ------------------------------
  --> | parallel_select_count_star() |
  |    ------------------------------
  |
  |
  |     /* CHECK TABLE */
  |    ------------------------
  --> | parallel_check_table() |
       ------------------------
基本数据结构
Parallel_reader::Scan_range:代表当前并行扫描的范围。
Parallel_reader::Config 并行扫描的 configuration.
Parallel_reader::Scan_ctx 并行扫描的上下文 (context).
Parallel_reader::Ctx 并行读取的执行上下文 (Parallel reader execution context)
Parallel_reader 并行扫描 reader
SELECT COUNT()
我们以全表扫描 SELECT COUNT() 为例,根据源码分析 Parallel Read 的原理:
/* SELECT COUNT() 的入口函数 */

static dberr_t parallel_select_count_star(Key_reader &reader, ulint *n_rows) {
  Counter::Shards n_recs;

  Counter::clear(n_recs);

  const buf_block_t *prev_block = nullptr;

  dberr_t err =
      reader.read([&](size_t id, const buf_block_t *block, const rec_t *rec,
                      dict_index_t *index, row_prebuilt_t *prebuilt) {
        Counter::inc(n_recs, id);

        /* Only check the THD state for the first thread. */
        if (id == 0 && block != prev_block) {
          prev_block = block;
          if (trx_is_interrupted(reader.trx())) {
            return (DB_INTERRUPTED);
          }
        }

        return (DB_SUCCESS);
      });

  /* 统计计数 */
  *n_rows = Counter::total(n_recs);

  return (err);
}
Key_reader 使用 partition() 将 B+ tree 分片,分配各个 worker 线程,InnoDB 的 B+ 树将数据存放在所有的叶子节点,即叶子节点为 level 0,分配策略是从 root 节点遍历,使用 left_leaf() 从左边由上至下直到 level N 层的节点数量大于等于 worker 线程数量:
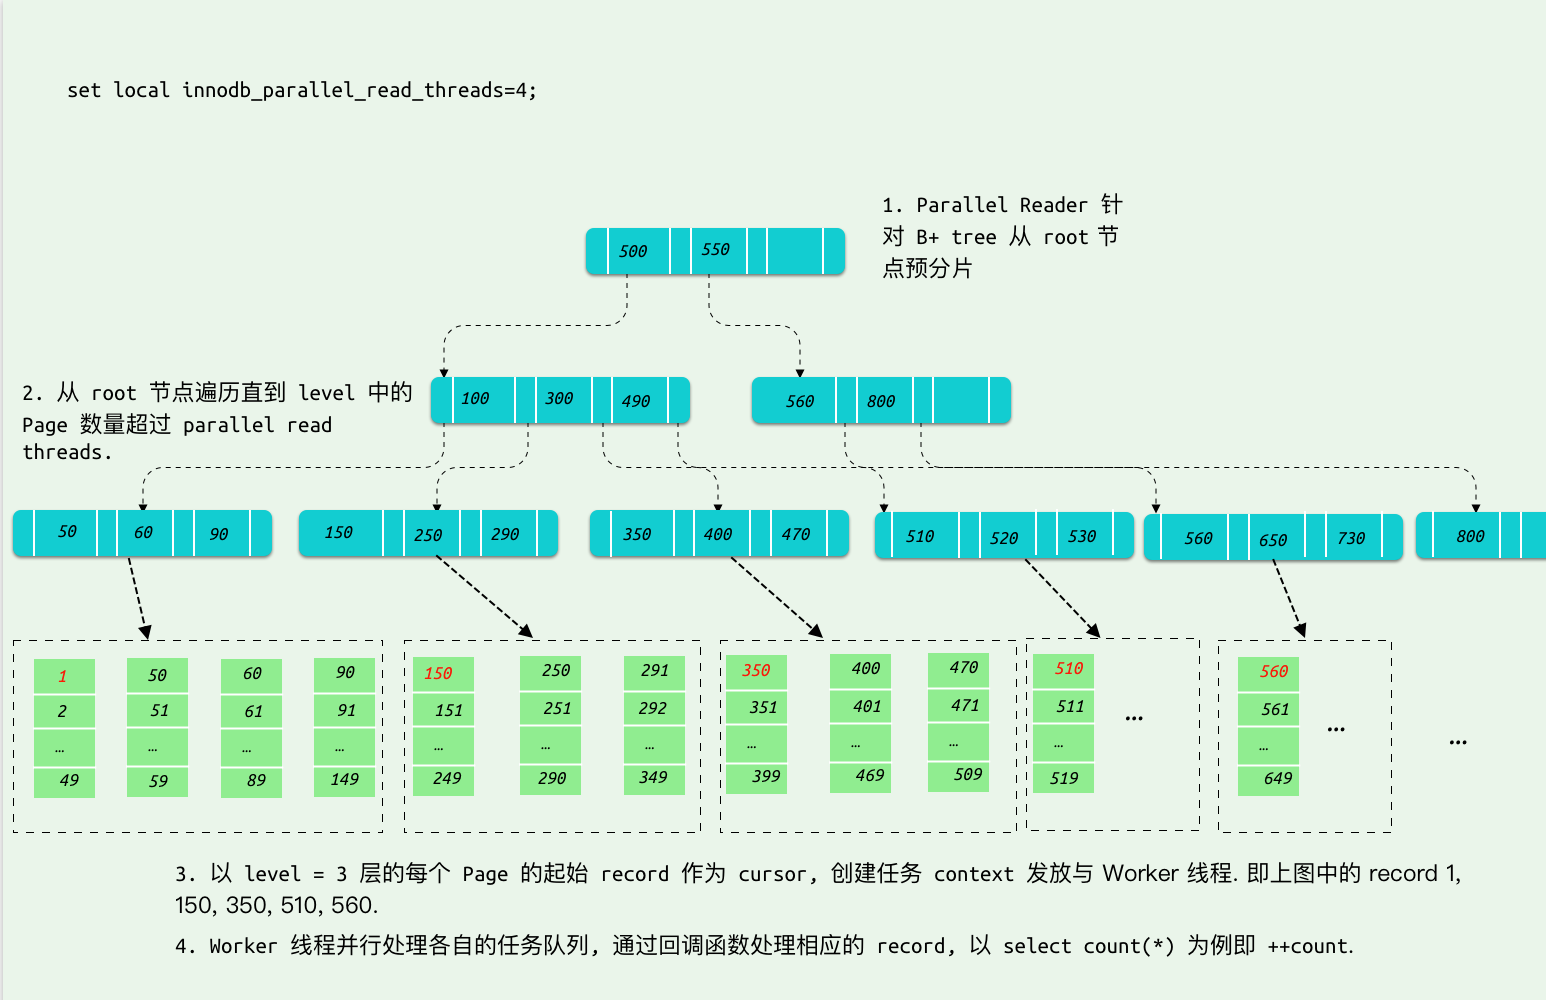
Key_reader 会在指定 level 的 sub-tree 的 “root page” 中分别选择第一个 record,从而找到其在 leaf level 层的 page no(create_range()->create_persistent_cursor()),新建 scan context 交由 worker 线程。
并行读取流程
启动 worker 线程,worker 线程也就是真正的读取线程,对一个切好的 sub-tree 做 scan, worker 线程分别根据被分配的 leaf page cursor 进行顺序读取。
并行读取线程会根据创建的读取对应叶子节点的 record,并且会根据 trx->read_view 来判断可见性。
总结
我们通过 SELECT COUNT() 分析了 InnoDB 实现的 Parallel Read 框架,虽然目前仅支持 CHECK TABLE 和 SELECT COUNT(),但整个框架支持了足够多的接口,后续应该会支持更多的场景。例如目前 CHECK TABLE 和 SELECT COUNT() 都是同步的并行读取,使用 Parallel Read 框架可以考虑针对 SELECT * 的全表扫描可以优化为异步的逻辑预读。